OpenAI 발표에 따르면 GPT-6.1 Sol은 복잡한 코드 수정, 문서 이해, 여러 단계를 이어가는 업무에서 이전 Sol보다 나아진 평가 결과를 보였습니다. 다만 그 점수만으로 내 작업의 시간 절약이나 오류 감소 폭까지 알 수는 없습니다. 같은 일을 맡겼을 때 완성본을 얼마나 덜 고쳐도 되는지가 궁금합니다.
2026년 9월 30일 확인한 발표를 바탕으로, 실제 작업에서 비교할 부분을 정리했습니다. GPT-6.1 Sol은 유료 플랜의 Work·Codex와 별도 API에 제공되며 일반 Chat의 모델 선택과는 구분됩니다. 이 글은 직접 사용한 성능 후기 대신 공식 평가와 비교 방법을 다룹니다.
1. DevDay 2026에서 무엇이 달라졌나
OpenAI는 미국 현지 9월 29일 DevDay 2026에서 20개가 넘는 주요 발표를 내놓았습니다. GPT-6.1 Sol 외에도 Codex 클라우드 작업, 지속적으로 일을 맡는 에이전트 Dots, 문서를 함께 만드는 Space와 Pages가 포함됐습니다. OpenAI DevDay 공식 정리에서 발표별 제공 대상을 확인할 수 있습니다.
이번 글에서는 모델이 일을 얼마나 잘 마치는지에 초점을 맞췄습니다. Space와 Pages는 자료를 모으고 결과물을 수정·공유하는 기능이므로, 사용법을 따로 다루는 편이 찾기 쉽습니다.
2. 코딩·PDF·여러 단계 작업의 개선 근거
코딩: 여러 파일을 고치는 과제
DeepSWE v1.1은 실제 코드베이스의 복잡한 소프트웨어 엔지니어링 작업을 평가합니다. OpenAI는 GPT-6.1 Sol이 이전 Sol의 최고 점수보다 6.4%포인트 높았고, 더 낮은 추론 노력과 비용으로 그 결과에 도달했다고 설명했습니다. 모든 설정을 똑같이 맞춘 속도 비교로 읽으면 안 됩니다. 한국어 발표의 코딩 평가에 비교 조건이 나와 있습니다.
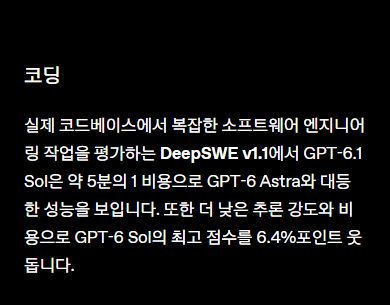
코드 수정에 적용한다면 요청한 기능이 동작하는지, 관련 파일을 빠뜨리지 않았는지, 기존 테스트가 통과하는지를 비교할 수 있습니다. 벤치마크의 6.4%포인트를 개발 시간이 6.4% 줄었다는 뜻으로 바꾸면 결과를 과장하게 됩니다.
PDF와 업무 수행: 읽은 뒤 끝까지 처리하는 과제
OpenAI는 복잡한 PDF를 다루는 GDP.pdf 평가에서도 Astra에 가까운 결과를 소개했습니다. 표·차트·작은 각주가 있는 문서를 함께 읽는 능력을 보는 평가입니다. 영문 발표의 전문 업무 평가를 근거로 볼 때, 이런 자료에서 숫자와 조건을 함께 추출하는 작업을 비교 대상으로 삼을 만합니다.
| 공식 평가 | 개선 폭과 조건 |
|---|---|
| AutomationBench | 이전 Sol 대비 4.8%포인트 상승. 두 모델의 추론 노력은 medium으로 동일합니다. |
| OSWorld 2.0 | 이전 Sol 대비 부분 보상 점수 7%포인트 상승. 추론 노력 max, 오프라인 v2026.08.08 평가입니다. |
AutomationBench는 업무를 이어서 수행하는 능력, OSWorld는 컴퓨터를 사용하는 능력의 근거로 제시됐습니다. 두 평가의 점수 체계와 조건이 다르므로 개선 폭을 합치거나 평균 내지는 않았습니다. 공식 평가 설명의 결과가 내 자료나 프로그램에서도 그대로 재현되는지는 별도 확인이 필요합니다.
3. 어디서 쓰고, API 가격은 얼마일까
발표 기준으로 Plus·Pro·Business·Enterprise·Edu 사용자가 Work와 Codex의 제공 대상입니다. 일반 Chat에서는 제공하지 않습니다. 릴리스 노트는 Pro부터 시작해 다른 대상 플랜으로 확대하는 배포와 Enterprise·Edu 관리자의 접근 허용 조건을 안내합니다. 대상 플랜이어도 계정에 표시되는 시점은 달라질 수 있습니다.
| API 항목 | 표준 가격: 100만 토큰당 |
|---|---|
| 입력 | 2달러 |
| 캐시된 입력 | 0.10달러 |
| 출력 | 10달러 |
API 모델 이름은 gpt-6.1-sol입니다. 위 표는 ChatGPT 월 구독료가 아니라 API 토큰 가격입니다. “Astra의 5분의 1 가격”이라는 발표 표현도 표준 입력·출력 토큰 단가를 비교한 것이므로 작업 한 건의 총비용이 항상 5분의 1이 된다는 뜻은 아닙니다.
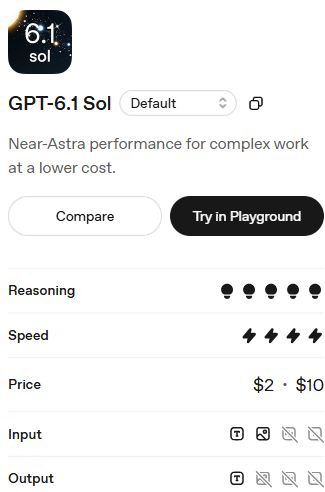
긴 입력과 처리 방식에도 가격 조건이 붙습니다. 개발자 모델 문서는 입력이 27만 2천 토큰을 넘으면 해당 요청 전체의 입력·캐시 가격은 2배, 출력 가격은 1.5배라고 안내합니다. Fast·Batch·Flex 등의 처리 방식도 표준 가격과 다르므로, 실제 비용은 사용 방식과 소비 토큰을 함께 봐야 합니다.
4. 내 작업이 좋아졌는지 비교하는 방법
블로그 작업이라면 PDF나 공식 발표 자료 하나로 시작할 수 있습니다. 같은 자료와 요청문을 기존에 쓰던 모델과 6.1 Sol에 주고, 원자료에서 미리 정해둔 정답 항목을 대조하는 방식입니다. 모델의 추론 노력, 연결 도구와 권한도 가능한 한 같게 맞춰야 차이를 읽기 쉽습니다.
설명용 비교 요청문

첨부 자료에서 날짜, 수치, 단위, 적용 조건을 추출해 표로 정리해줘.
각 항목에 근거가 있는 페이지나 문단을 표시해줘.
서로 다른 조건의 수치는 합치지 말고, 확인할 수 없는 값은 미확인으로 남겨줘.
이 표를 바탕으로 독자가 이해할 수 있는 짧은 설명을 작성해줘.

완성본에 틀린 숫자나 빠진 조건이 있는지 먼저 봅니다. 이어 수정 요청을 몇 번 했는지, 사람이 손으로 고친 시간까지 얼마나 들었는지를 기록합니다. API를 쓴다면 실제 소비 토큰과 비용도 남기면 됩니다. 첫 답이 빨리 나왔어도 뒤에 고칠 일이 늘었다면 작업 전체가 빨라졌다고 보기는 어렵습니다.
난도가 비슷한 과제를 여러 번 비교하면 한 번의 좋은 결과에 판단을 맡기는 일을 줄일 수 있습니다. OpenAI도 가장 어려운 과학 연구 과제에서는 Astra가 앞선다고 설명합니다. 자주 하는 작업의 완성도가 충분한지부터 확인하고, 더 어려운 과제에 어떤 모델이 필요한지 판단하면 됩니다. OpenAI 모델 선택 안내도 작업에 맞춰 평가할 것을 권합니다.
자료 기준일: 2026-09-30. 자료 조사·원고 작성·교정과 대표 삽화 제작에 AI를 활용했습니다.
'AI·IT 이야기' 카테고리의 다른 글
| 코파일럿 오토파일럿, 내가 자리를 비워도 어떤 일까지 할까? (0) | 2026.09.27 |
|---|---|
| 크롬 시크릿 모드, 창을 닫으면 무엇이 지워지고 남을까? (1) | 2026.09.26 |
| USB-C인데 왜 충전만 되고 모니터는 안 나올까? (0) | 2026.09.26 |
| 와이파이 2.4GHz·5GHz 중 어디에 연결할까? 거리·속도·기기 기준 (0) | 2026.09.25 |
| SF 영화 속 우주 폭발음, 실제로는 들릴까? NASA 자료로 본 소리와 전파 (0) | 2026.09.24 |